Was bestätigt der Eintrag in awesome-fsrs?
Quanta ist im Verzeichnis awesome-fsrs gelistet: Pull Request #54, gemergt am 21. Mai 2026. Den Eintragstext hat Quanta selbst eingereicht. Der GitHub-Vorgang nennt L-M-Sherlock als zusammenführendes Konto und enthält keine dokumentierte Review. Daraus folgt keine fachliche Prüfung aller beworbenen Funktionen.
Das Verzeichnis awesome-fsrs sammelt Anwendungen, Bibliotheken und weitere Ressourcen rund um FSRS. Es ist weder auf FSRS-6 beschränkt noch ein vollständiger Marktvergleich. Der damalige Eintrag beschreibt Quellenbelege, Bloom-Vorgaben und Multiple-Choice-Tests als Produktmerkmale.
Für die heutige Nutzung zählt die tatsächliche Umsetzung. Ein historischer Verzeichnistext bestätigt keine aktuelle Tarifgrenze und keinen Lernerfolg. Die folgenden Abschnitte trennen deshalb Rechenkern, Generierung und Qualitätskontrolle. Keine dieser Schichten kann die anderen ersetzen.
Wie plant Quanta Wiederholungen mit FSRS-6?
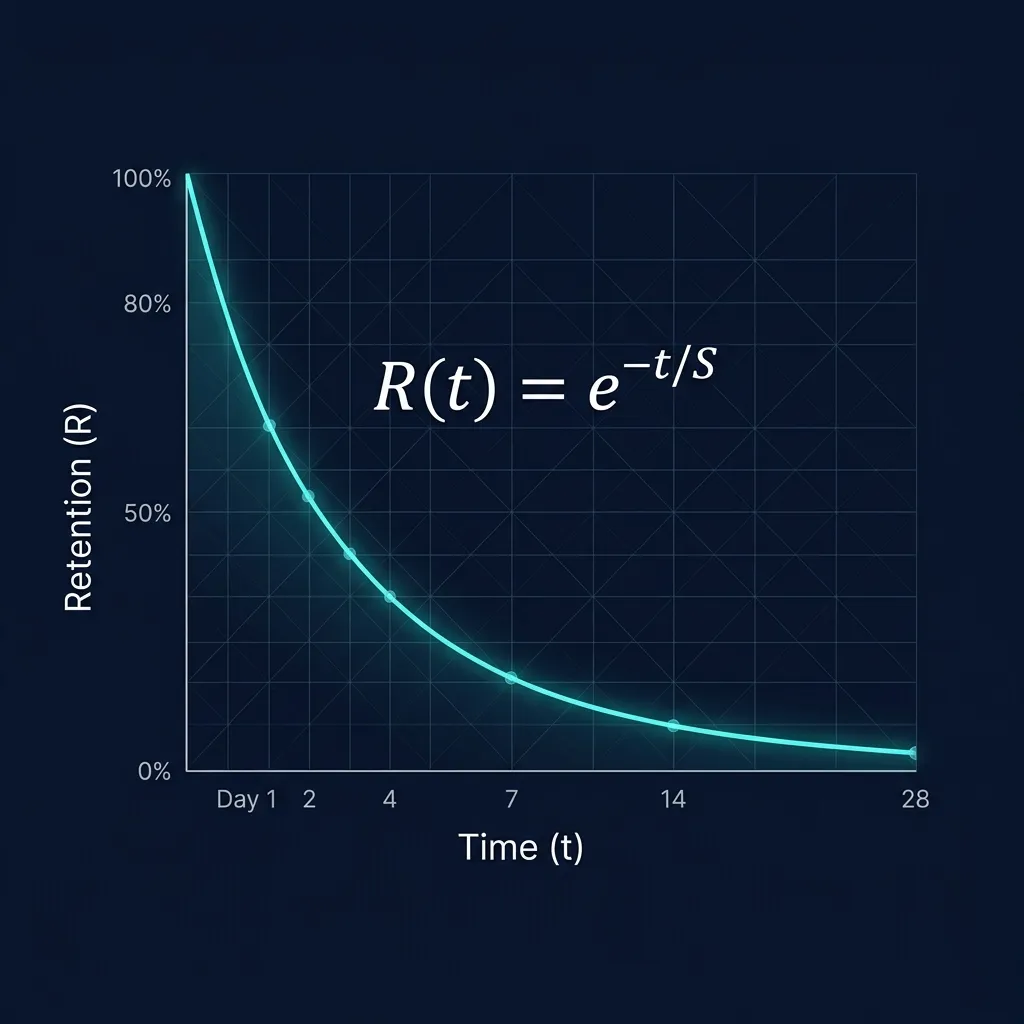
Quanta verwendet die TypeScript-Bibliothek ts-fsrs als Rechenkern. Nach deiner Bewertung einer Karteikarte aktualisiert der Scheduler Schwierigkeit, Stabilität und nächsten Wiederholungstermin. Die Bewertung beschreibt deine Antwort, nicht die fachliche Qualität der Karteikarte.
Schwierigkeit ist ein modellierter Wert zwischen 1 und 10. Stabilität bezeichnet die Zeitspanne, nach der das Modell noch 90 Prozent Abrufwahrscheinlichkeit annimmt. Die aktuelle Wahrscheinlichkeit berechnet ts-fsrs mit einer Potenzkurve aus Stabilität und vergangener Zeit. Eine Prognose des Modells ist keine Messung deines Gedächtnisses.
Quanta berechnet diese Termine auch bei offline beantworteten Karteikarten. Daraus folgt nicht, dass jeder Prüfungsmodus denselben Wiederholungsablauf nutzt. Auch Anki bietet FSRS in den Stapeloptionen an; ein zusätzliches Plugin ist dafür nicht erforderlich. Preise nennt Anki-Preise.
Was belegt eine Quelle an einer KI-Karteikarte?
Im quellenbasierten Themenweg erzeugt Quanta Karteikarten und Multiple-Choice-Tests aus bereitgestelltem Quelltext. Der Server prüft Zitate gegen diesen Text. Inhalte ohne passenden Beleg werden in diesem Weg verworfen. Der sichtbare Quellenstatus macht nachvollziehbar, worauf eine Antwort gestützt ist.
Wörtliche Übereinstimmung und inhaltliche Unterstützung sind unterschiedliche Prüfungen. Eine wiedergefundene Textstelle allein beweist nicht, dass die Antwort sie richtig auslegt oder die Quelle sachlich stimmt. Bei eigenen Dokumenten müssen zudem Text, Formeln und Abbildungen im richtigen Zusammenhang gelesen werden.
Daneben gibt es einen bewusst gewählten Weg aus Modellwissen, der als ungeprüft gekennzeichnet wird. Die Unterschiede erklärt Quanta Verified. Eine historische Gemini-Messung beschreibt der Zitat-Test. Sie bewertet nicht die heutige Produktqualität.
Was prüft Quanta bei einer Niveauauswahl?
Quanta bündelt die sechs Bloom-Stufen zu drei Niveaus: Wissen und Verstehen, Anwenden und Analysieren, Beurteilen und Entwickeln. Die revidierte Taxonomie beschreibt unterschiedliche Lernziele; eine Stufe allein bewertet keine Aufgabe als gut oder schlecht.Quelle Krathwohl, D.R. (2002). A Revision of Bloom's Taxonomy: An Overview. Theory Into Practice 41(4), 212-218. https://doi.org/10.1207/s15430421tip4104_2 · im Quellenapparat
In einem berechtigten Bezahlkonto kannst du das gewünschte Niveau auswählen. Die Generierung erhält diese Auswahl als Vorgabe. Anschließend prüft Quanta Formmerkmale des Fragestamms und fordert bei Verfehlungen nach. Diese Prüfung garantiert keine richtige kognitive Einstufung jeder Aufgabe.
Ohne eigene Auswahl wird eine Mischung vorgegeben; eine konkrete ausgewählte Form wird dann nicht geprüft. Eine Definitionsfrage bleibt zulässig. Die Unterschiede erläutert die Bloom-Taxonomie.
Warum bleibt eigener Abruf entscheidend?
Karpicke und Roediger (2008) berichten nach einer Woche rund 80 % erinnerte Vokabelpaare in den Bedingungen mit wiederholtem Abruf und 36 % und 33 % in den Bedingungen, in denen Paare nach dem ersten Treffer aus dem Test genommen wurden. Diese Werte gelten für die Versuchsanordnung, nicht als Wirkversprechen für Quanta.Quelle Karpicke, J.D.; Roediger, H.L. (2008). The Critical Importance of Retrieval for Learning. Science 319(5865), 966-968. https://doi.org/10.1126/science.1152408 · im Quellenapparat
Praktisch heißt das: Beantworte die Frage zunächst ohne sichtbare Lösung. Vergleiche anschließend deine Antwort mit der Quelle und bewerte sie ehrlich. Ein passendes Wiederholungsdatum hilft erst, wenn du die Aufgabe tatsächlich selbst bearbeitest.
Wie prüft Quanta Multiple-Choice-Fragen?
Haladyna und Downing (1989) beschreiben Regeln zur Erstellung von Multiple-Choice-Aufgaben, darunter plausible Falschantworten. Quanta gibt dem Modell vor, solche Distraktoren zu erzeugen und fachlich unterschiedliche Antwortoptionen zu formulieren. Eine Vorgabe ist jedoch noch kein Nachweis, dass jede erzeugte Frage sie erfüllt.Quelle Haladyna, T.M.; Downing, S.M. (1989). A Taxonomy of Multiple-Choice Item-Writing Rules. Applied Measurement in Education 2(1), 37-50. https://doi.org/10.1207/s15324818ame0201_3 · im Quellenapparat
Eine zusätzliche Prüfschicht sucht nach ausgewählten Strukturfehlern und Auffälligkeiten der Optionen. Heuristische Befunde sind keine vollständige fachliche Plausibilitätsprüfung. Fachlich unplausible Falschantworten können deshalb die technischen Prüfungen passieren.
Falsch beantwortete oder offen gebliebene Fragen lassen sich aus dem Ergebnis erneut üben. Dieser Durchgang startet auf Anforderung und erhält keinen FSRS-Termin. Vorher solltest du verstehen, weshalb deine Antwort nicht trägt; dieselbe Option wiederzuerkennen genügt dafür nicht. Beispiele erläutert KI-Karteikarten die wirklich funktionieren.
Welche Ergebnisse sind wissenschaftlich belegt?
Im offenen srs-benchmark erreicht FSRS-6 einen Log-Loss von 0,3460 ± 0,0042 auf 349.923.850 Wiederholungen aus 9.999 Sammlungen (abgerufen am 5. September 2026). Log-Loss misst den Vorhersagefehler, kleiner ist besser. Diese Tabelle führt keine Zeile für SM-2 und misst keine gesparten Lernstunden in Quanta.Quelle open-spaced-repetition (2026). srs-benchmark (vormals fsrs-benchmark): Vergleich von Wiederholungs-Algorithmen auf offenen Anki-Daten. GitHub. 349.923.850 Wiederholungen aus 9.999 Sammlungen. github.com · im Quellenapparat
Ye et al. (2022) untersuchten zuvor Planungsstrategien für verteilte Wiederholungen. Ihr Vergleich unter simulierten Bedingungen ist frühere Forschung zum Problem, kein Test der heutigen FSRS-6-Implementierung in Quanta. Forschungsmodell, Simulator und ausgelieferter Scheduler dürfen nicht gleichgesetzt werden.Quelle Ye, Junyao; Su, Jingyong; Cao, Yilong (2022). A Stochastic Shortest Path Algorithm for Optimizing Spaced Repetition Scheduling. Proceedings of the 28th ACM SIGKDD Conference on Knowledge Discovery and Data Mining, 4381-4390. https://doi.org/10.1145/3534678.3539081 · im Quellenapparat
Für deine Entscheidung zählt daher die passende Aufgabe: Quelle prüfen, selbst antworten, Rückmeldung nutzen und fällige Karteikarten wiederholen. Die Unterschiede der Verfahren beschreibt FSRS vs. SM-2. Verzeichniseintrag, Forschungsbefund und eigener Prüfungserfolg bleiben unterschiedliche Aussagen.